Si vous travaillez assez longtemps avec des agents de code, vous finissez avec un dossier plein de PLAN.md, TODO.md, PHASE_2_PLAN_v3.md. C’est ce qui m’est arrivé. L’agent écrit un plan, commence à travailler, le contexte se remplit, la session est compactée, et la session suivante ignore le plan ou en écrit un nouveau.
Le symptôme le plus grave est plus discret. Après quelques compactions, l’agent oublie les premières phases du plan et vous annonce tranquillement que le projet est terminé. Ce n’est pas le cas. La moitié du travail dort encore dans un fichier markdown que plus personne ne lit.
Beads règle ce problème. C’est un gestionnaire de tickets, mais pensé d’abord pour les agents, et ensuite pour les humains. Cet article explique ce que c’est, comment l’installer, et la partie qui m’a convaincu de l’adopter : suivre le travail sur plusieurs dépôts, avec des tâches d’un projet bloquées par des tâches d’un autre.
Ce qu’est Beads
Beads est une CLI qui s’appelle bd. Vous lancez bd init dans un dépôt, et il crée un dossier .beads/ qui contient une petite base de données de tickets. Votre agent crée des tickets, se les attribue, les relie entre eux et les ferme avec de simples commandes shell.
Quelques choix de conception le distinguent de GitHub Issues ou de Jira :
- Il vit dans le dépôt. Pas d’application web, pas de jeton d’API. L’agent a déjà un shell, donc il y a déjà accès.
- C’est un graphe, pas une liste. Les tickets ont des dépendances.
bd readyne renvoie que le travail qui n’a aucun bloqueur ouvert. C’est cette seule commande que l’agent lance au début de chaque session. - Les identifiants n’entrent pas en collision. Les tickets reçoivent des identifiants basés sur un hash, comme
bd-a1b2au lieu de#5, donc deux agents sur deux branches peuvent créer des tickets en même temps sans conflit de merge. - Le travail ancien est compacté. Les tickets fermés peuvent être résumés pour arrêter de grignoter la fenêtre de contexte.
Le stockage a évolué avec le temps. Les premières versions écrivaient les tickets en JSONL dans git, avec un cache SQLite et un daemon en arrière-plan. Les versions actuelles tournent sur Dolt, une base SQL versionnée à la manière de git, embarquée par défaut. Le fichier JSONL est toujours exporté, mais ce n’est plus la source de vérité. Beaucoup de conseils d’installation qu’on trouve en ligne datent d’avant ce changement, alors vérifiez la version.
C’est open source (MIT), écrit en Go, et ça se trouve sur github.com/gastownhall/beads.
Prise en main
Installez-le :
brew install beads
# ou
npm install -g @beads/bd
Puis dans votre projet :
cd ~/code/my-app
bd init
Vous lancez bd init une seule fois. Ensuite, l’agent fait l’essentiel du travail. Il faut juste lui dire que Beads existe. Ajoutez une ligne comme celle-ci à votre CLAUDE.md ou AGENTS.md :
Use `bd` for task tracking. Run `bd prime` at the start of a session,
`bd ready` to find work, and file an issue for anything you discover
but don't fix right now.
bd prime affiche un court guide de workflow fait pour les agents, ainsi que les mémoires enregistrées avec bd remember. C’est le moyen le plus rapide de mettre l’agent à niveau sans coller de documentation dans le prompt.
Les commandes que vous verrez votre agent lancer le plus souvent :
bd create "Add rate limiting to the API" -p 1   # priorité 1
bd ready                                        # travail débloqué
bd update bd-a1b2 --claim                       # je m'en occupe
bd show bd-a1b2                                 # détails + dépendances
bd dep add bd-c3d4 bd-a1b2                      # c3d4 dépend de a1b2
bd close bd-a1b2
Attention à l’ordre dans bd dep add : le premier ticket est celui qui attend, le second est le bloqueur. Je me suis trompé de sens la première fois.
Si vous avez déjà une pile de fichiers TODO, la migration tient en un prompt : « transforme tout le contenu de TODO.md en tickets beads, avec les dépendances ». L’agent l’analyse et construit le graphe.
Voir le tableau
Beads n’a pas d’interface à lui, c’est voulu. Mais comme les données sont locales et ouvertes, la communauté en a construit plein. J’utilise beads-ui :
npm i -g beads-ui
bdui start --open
Ça ouvre une page web locale avec un tableau découpé en Blocked, Ready, In progress et Closed, une vue des epics avec leur avancement, et des mises à jour en direct pendant que l’agent travaille. Regarder les tickets passer d’une colonne à l’autre pendant que Claude Code tourne dans le terminal, c’est franchement le meilleur moyen de voir ce que fait l’agent sans lire chaque ligne de sortie.
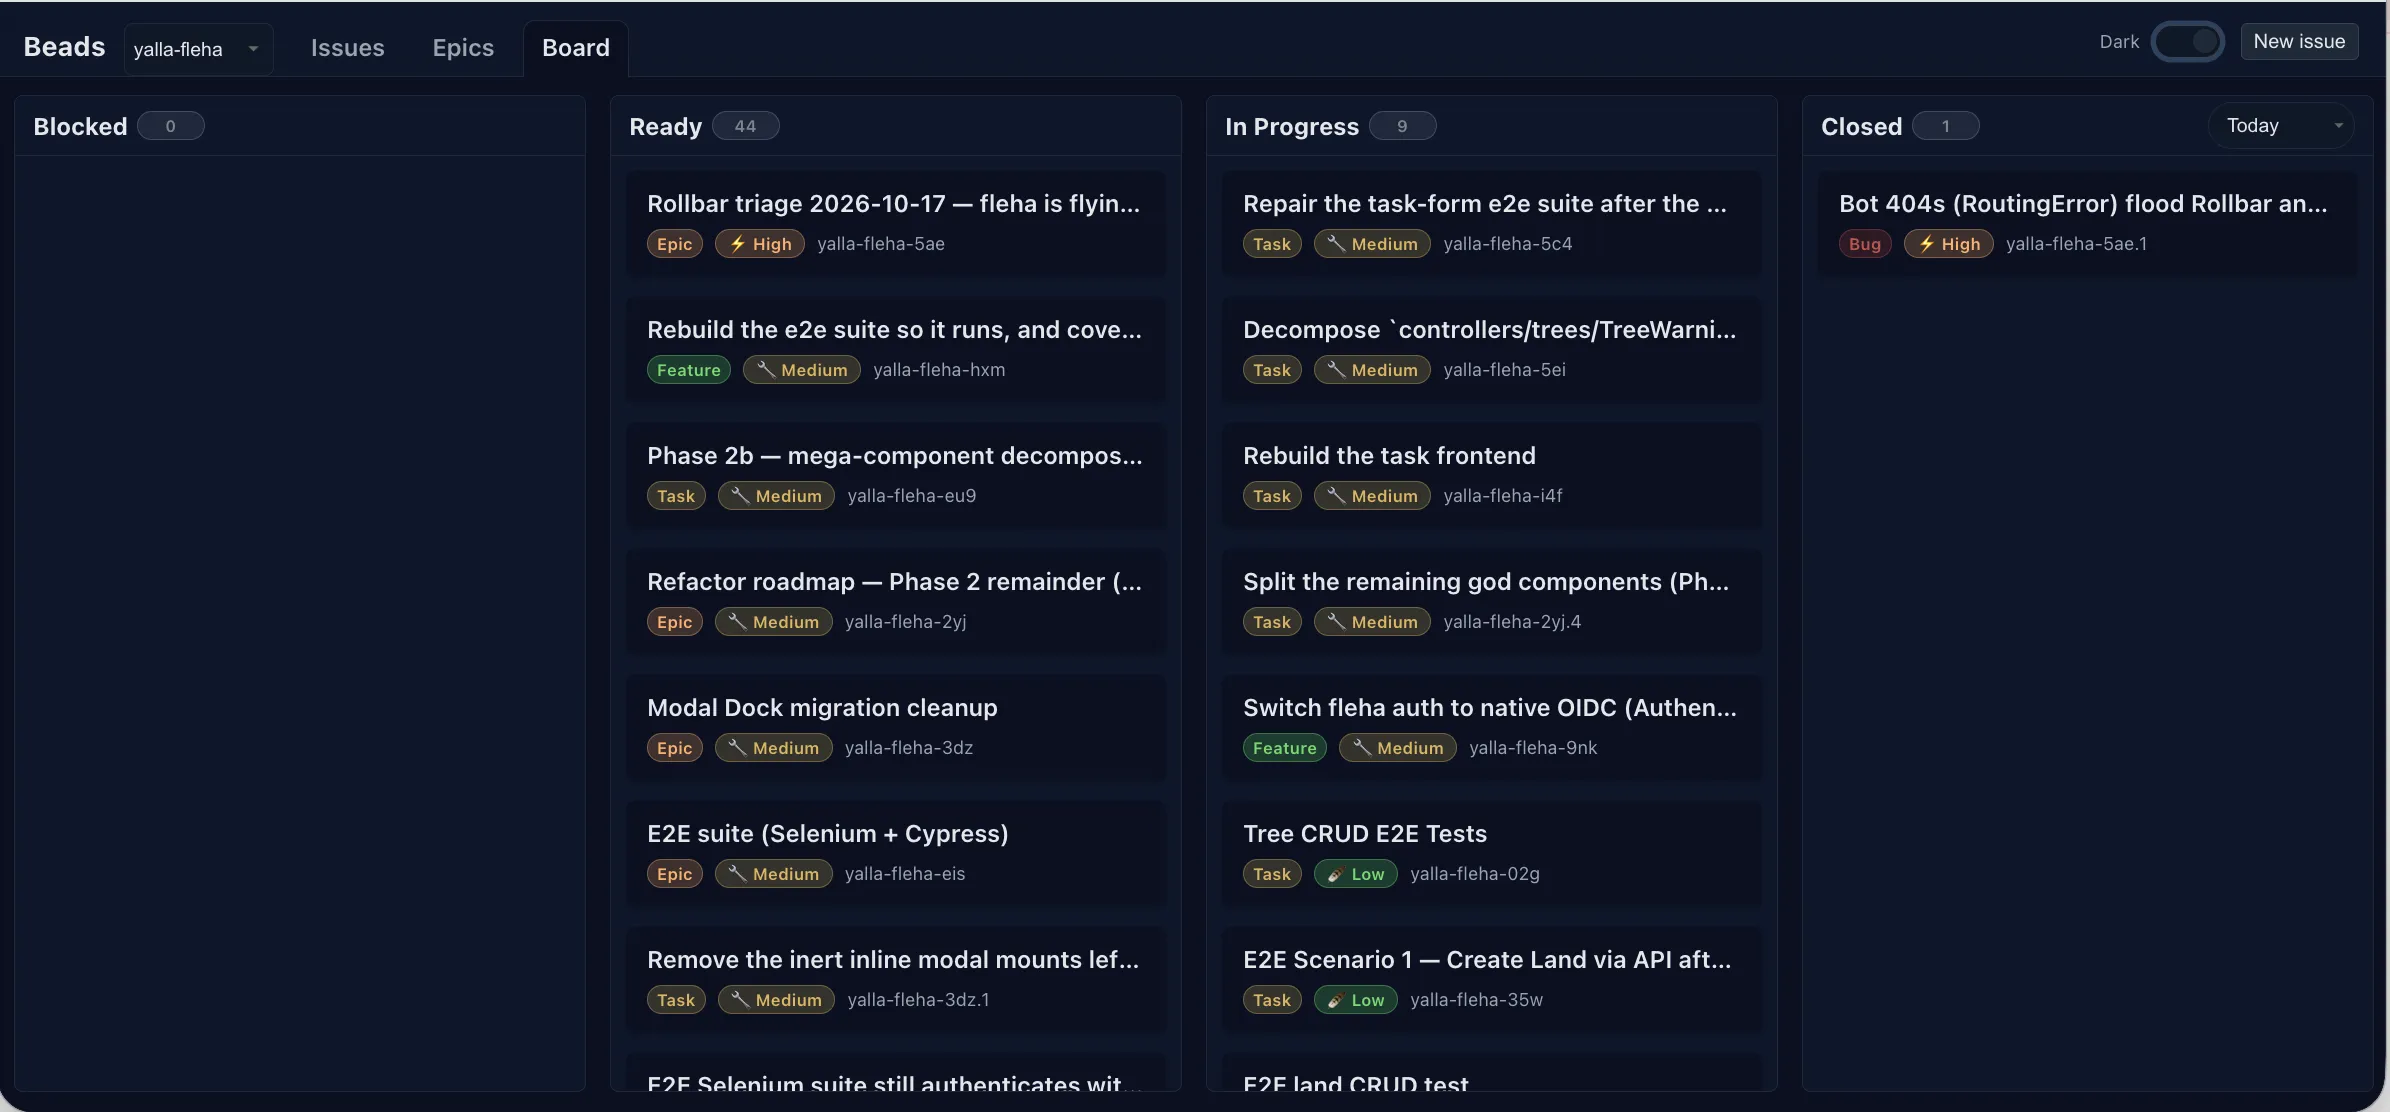
Si vous préférez le terminal, il existe aussi des TUI (b9s, perles, LazyBeads), et même une extension kanban pour VS Code.
Multi-dépôts : une vue, plusieurs projets
C’est la partie qui compte le plus pour moi. Mes projets ne sont pas isolés. J’ai un service d’authentification dont dépendent plusieurs de mes applications SaaS. Quand je veux une fonctionnalité dans une application, une fois sur deux, elle a d’abord besoin de quelque chose dans le service d’auth. Un fichier TODO par dépôt ne peut pas exprimer ça.
Beads gère ça avec l’hydratation : un dépôt peut importer les tickets d’autres dépôts dans sa propre vue. Chaque dépôt garde sa propre base et son préfixe, et vous choisissez un endroit où tout se rejoint.
Donnez à chaque dépôt un préfixe distinct à l’initialisation, pour reconnaître les tickets d’un coup d’œil :
cd ~/code/auth
bd init --prefix auth

cd ~/code/app
bd init --prefix app
Ensuite, depuis le dépôt de l’application, ajoutez le dépôt d’auth comme source supplémentaire et synchronisez :
cd ~/code/app
bd repo add ../auth
bd repo sync
bd repo list
bd repo sync lit les tickets exportés de l’autre dépôt et les importe avec leur préfixe d’origine, marqués avec leur provenance. À partir de là, bd list et bd ready dans app affichent les tickets des deux projets.
La synchronisation entre machines est un sujet à part : Beads utilise les remotes Dolt, donc vous lancez bd dolt push et bd dolt pull, comme quand vous poussez du code.
Une tâche bloquée par un autre dépôt
Voici le cas concret. Dans le service d’auth, j’ai besoin d’un nouvel endpoint :
cd ~/code/auth
bd create "Expose /oauth/google endpoint" -p 1
# → auth-k2m9
Dans l’application, je veux un bouton « Sign in with Google », qui ne sert à rien tant que cet endpoint n’existe pas :
cd ~/code/app
bd create "Add Sign in with Google button" -p 1
# → app-r7t4

bd repo sync
bd dep add app-r7t4 auth-k2m9
Désormais, app-r7t4 dépend de auth-k2m9. Quand un agent dans le dépôt de l’application lance bd ready, la tâche du bouton n’apparaît pas. Elle reste dans Blocked sur le tableau, et bd show app-r7t4 explique exactement pourquoi à l’agent.
Tout l’intérêt est là. Sans ça, l’agent prend le bouton, ne trouve pas l’endpoint, et soit il bricole une fausse implémentation, soit il se met à modifier un dépôt auquel il ne devrait pas toucher. Avec, l’agent travaille sur autre chose.
Quand le côté auth est livré :
cd ~/code/auth
bd close auth-k2m9 --reason "Endpoint live on staging"

cd ~/code/app
bd repo sync
bd ready
# → app-r7t4 est maintenant prêt
Un point à retenir : l’application ne voit le nouvel état qu’après bd repo sync. Je l’ai ajouté aux instructions de mon CLAUDE.md pour que l’agent synchronise avant de demander le travail prêt.
Il existe aussi une forme plus souple, external:<project>:<capability>, quand vous dépendez d’une capacité d’un autre projet plutôt que d’un ticket précis. Je n’en ai pas encore eu besoin, le simple lien d’un ticket à un autre couvre mes cas.
D’autres configurations fonctionnent de la même façon :
- Un dépôt de planification pour l’open source. Vos notes et vos tâches vont dans un dépôt privé (
~/.beads-planning), pour que vos PR en amont ne contiennent que du code.bd init --contributorle met en place. - Partagé et personnel. Les tickets de l’équipe dans le dépôt partagé, les expériences dans un dépôt perso, les deux visibles ensemble.
- Par phases. Des dépôts séparés pour la planification, l’implémentation et la maintenance, agrégés dans celui de l’implémentation.
Soyons honnêtes
Beads n’a rien de magique.
Les agents ne l’utilisent pas d’eux-mêmes. Si ce n’est pas dans votre CLAUDE.md, l’agent n’y pensera pas. Même avec l’instruction, il faudra parfois lui rappeler de créer un ticket pour le bug qu’il vient de trouver au lieu de le mentionner en passant.
C’est jeune et ça bouge vite. Lancez bd doctor de temps en temps, il détecte et corrige la plupart des problèmes de configuration, et mettez à jour régulièrement. Les anciennes versions avec le daemon en arrière-plan pouvaient échouer à synchroniser sans rien dire, et des tickets disparaissaient en silence. Le backend Dolt est beaucoup plus tranquille, mais je jette quand même un œil au tableau après une synchro.
Gardez la base petite. Nettoyez régulièrement les tickets fermés et restez sous quelques centaines de tickets ouverts. Les agents lisent parfois tout le fichier d’export, et au-delà d’une certaine taille, il ne tient plus dans le contexte.
Et pour une tâche qui tient en une seule session, vous n’en avez pas besoin. Les tâches intégrées de Claude Code suffisent. Ma règle : est-ce que j’aurai besoin de ce contexte dans deux semaines ? Si oui, Beads. Sinon, inutile de s’embêter.
Rien de tout ça n’est rédhibitoire. Ce sont de petites habitudes à prendre, pas des raisons de s’en passer.
Ça change tout
J’ai essayé beaucoup d’outils autour des agents de code. La plupart sont sympas pendant une semaine, puis j’oublie qu’ils existent. Beads est le premier qui a changé ma façon de travailler au quotidien.
Avant, je commençais chaque session en expliquant ce qui était fait, ce qui restait, et à quoi il ne fallait pas toucher. Maintenant, j’ouvre le terminal, l’agent lance bd ready, et il sait. Il reprend exactement là où la dernière session s’est arrêtée, même si c’était il y a trois jours et deux compactions. Quand il trouve un bug en chemin, il crée un ticket au lieu de l’oublier. Et il ne commence plus un travail qui dépend de quelque chose de pas encore terminé dans un autre dépôt.
C’est ce dernier point qui m’a convaincu. Mes projets dépendent les uns des autres, et pour la première fois, mes agents voient ces liens au lieu de les deviner.
L’agent a cessé d’être un assistant brillant sans mémoire pour se comporter comme un coéquipier qui connaît le backlog. Pour moi, c’est le plus grand pas en avant depuis que j’ai commencé à utiliser des agents de code.